项目案例
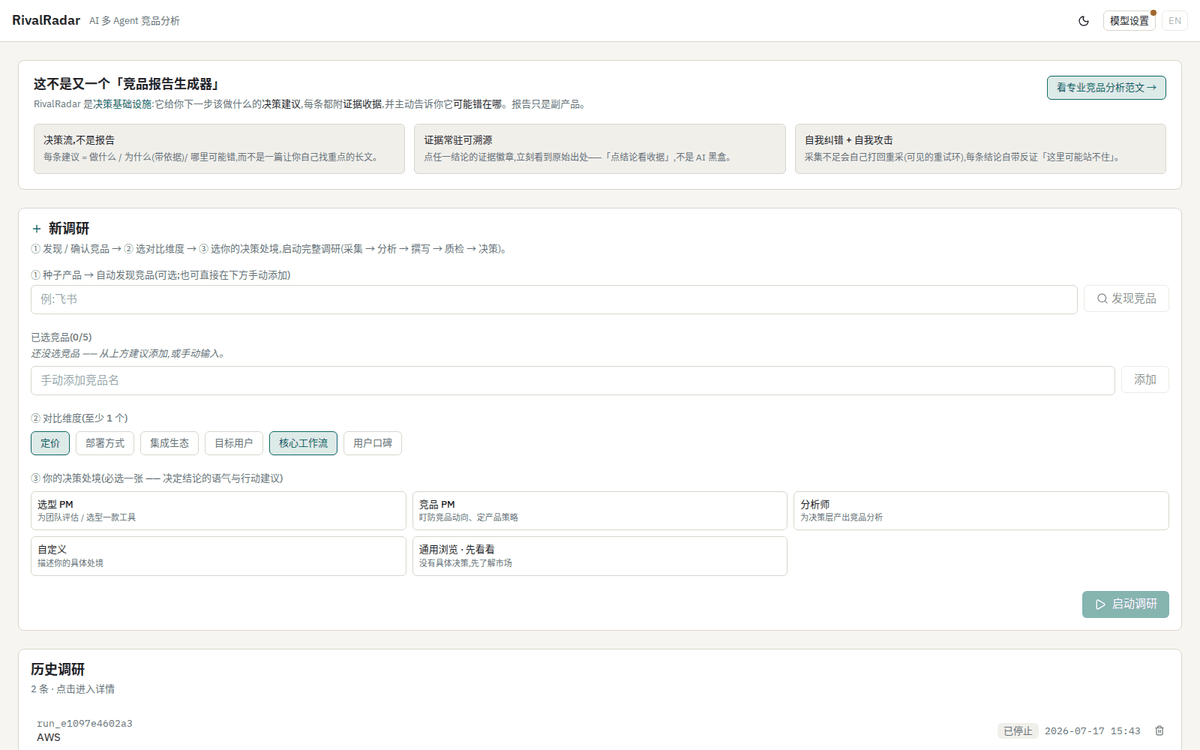
RivalRadar
字节跳动 CIS AI 全栈项目挑战赛 · 优秀项目奖
字节跳动 CIS AI 全栈项目挑战赛优秀项目奖。独立全栈,三周完成核心版本,把竞品研究从「黑盒长报告」做成「每条结论都能回查证据」的可复核流程
背景
产品经理做竞品研究有三个老问题,资料散、横向对比口径乱、AI 给的结论没法核。报告附了链接,不代表原文真支持结论,用的人还是得自己点开网页,一句一句找证据。AI 直接生成的竞品报告,结论看似成型,但没法核验出处,研究过程也不可见,产品经理不敢直接拿去决策,所以品类必须换,从报告生成器换成可复核的决策支持。
判断
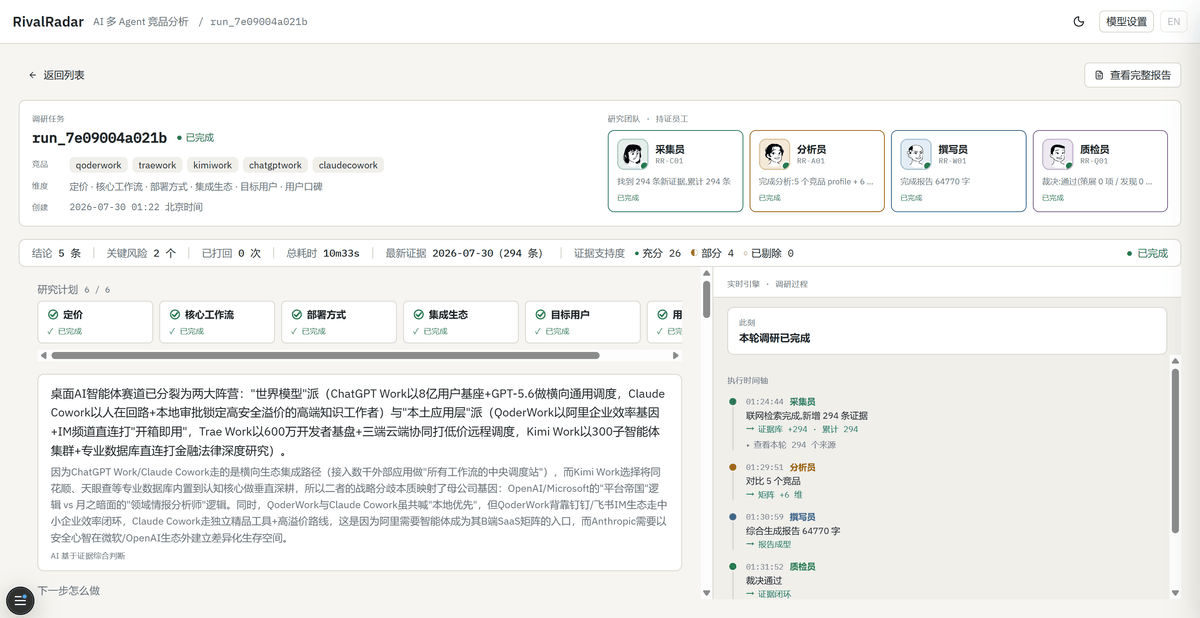
先说拆分。单一模型直出长报告,过程看不见,出了错也没法定位。我按独立目标、可检查产物、单独返工路径这三条标准,拆出采集、分析、撰写、质检四类 Agent,用 LangGraph 编排成采集、分析、撰写、质检、决策、终态的闭环。质检不过,就按缺口类型定向返工。
再说我最在意的设计,结论准入。光附链接不算数,每条对比结论和决策建议都必须绑定来源和引用原句。规则门先查引用存在、维度合法、证据覆盖,再由 LLM 逐条判定充分支持、部分支持还是不支持。不支持的剔除,部分的标注边界,缺证据的有限补采,补完还不够就显式留白。宁可空着,不能硬答。
质检这个角色也翻转过一次。初版质检只会整体打回,曾把接近完成的矩阵误判成数据不足。我把它重设计成分级处置:缺证据回采集定向补采,结构异常回分析重整,撑不住的剔除留白,每条结论的可信状态都摆给用户看。
最后是过程即信任。Agent 产品的信任来自过程透明,不是结果漂亮。实时工作台把检索词、来源、逐格校验、自我纠错环都推给用户看。页面刷新了,过程还能完整回放。
行动
个人独立全栈,三周做完比赛核心版本,赛后迭代不计入获奖版本。后端 FastAPI 加 LangGraph 加 SQLite/Postgres,前端 React 19。评测数字是赛后补测的:在 60 条结论—证据评测集上(三类支持关系各 20 条,我构造并标注),证据支持度判定 Macro-F1 88.4%,无依据结论识别 Precision 和 Recall 都是 90%,人工复核修正率 11.7%。评测是用来指导迭代的,不是用来装点门面的。工程上守几条线,降级必可见、不静默吞错、反套话黑名单。402 个测试、44 个测试文件全绿,约 13 秒跑完。
结果
- 获字节跳动 CIS AI 全栈项目挑战赛优秀项目奖。在线版本可以完整体验,竞品发现、资料采集、结构化对比、决策建议、原文回查,整条链路都通
- 已知边界也写在这。语义级核验有覆盖边界,只覆盖对比矩阵和决策建议,管不到全部自由文本。LLM 判定证明的是「结论—证据」的蕴涵关系,不证明结论的客观正确,结论本身对不对,还得人来判断